KI-Sichtbarkeit messen – welche Kennzahlen taugen?
Von Andreas Junius · Stand: September 2026 · 10 Min. Lesezeit
KI-Sichtbarkeit messen – welche Kennzahlen taugen?
Was soll eine Kennzahl für KI-Sichtbarkeit überhaupt messen?
Eine Kennzahl sollte einen klar abgegrenzten Teil der Sichtbarkeit beschreiben – etwa eine Erwähnung, eine Quellenangabe, einen technischen Abruf oder einen daraus entstandenen Besuch.
KI-Sichtbarkeit ist keine einzelne Messgröße. Ein KI-System kann Informationen aus mehreren Quellen zusammenführen, ein Unternehmen im Antworttext erwähnen oder eine Website als Quelle angeben. Ein technischer Zugriff auf eine Seite ist wiederum etwas anderes als eine Zitierung.
Für die Messung muss deshalb zuerst festgelegt werden, welcher Vorgang betrachtet wird.
Das klingt selbstverständlich. In der Praxis ist genau diese Abgrenzung entscheidend. Eine Zahl kann korrekt erhoben sein und trotzdem die falsche Frage beantworten.
Welche Kennzahlen können KI-Sichtbarkeit abbilden?
Sinnvoll sind mehrere Kennzahlen, die unterschiedliche Stufen der Sichtbarkeit abbilden. Keine davon beschreibt allein die gesamte Präsenz eines Unternehmens in KI-Antworten.
Erwähnungen
Eine einfache Messgröße ist die Frage, ob ein Unternehmen, eine Marke oder eine Website in einer KI-Antwort erwähnt wird.
Dafür wird ein festgelegtes Set von Suchanfragen beziehungsweise Prompts abgefragt und dokumentiert, in wie vielen Antworten die gewünschte Entität vorkommt.
Die Kennzahl hat allerdings eine klare Grenze: Eine Erwähnung sagt zunächst nur, dass etwas erwähnt wurde. Sie sagt nicht, welche Bedeutung die Erwähnung für die Antwort hat.
Eine Erwähnungsrate sollte deshalb nicht unmittelbar als Beleg für eine bestimmte Position im Entscheidungsprozess interpretiert werden.
Zitierungen
Eine Zitierung geht einen Schritt weiter. Hier wird geprüft, ob eine Website beziehungsweise eine konkrete Quelle in einer KI-Antwort als Quelle angegeben wird.
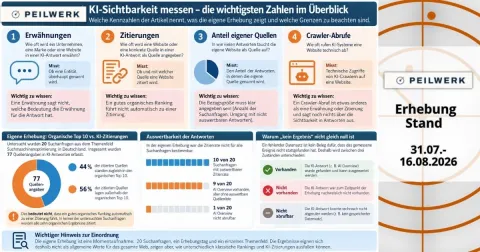
Eine eigene Erhebung vom 31.07.2026 zeigt, wie unterschiedlich klassische Rankings und KI-Zitierungen ausfallen können. Untersucht wurden 20 Suchanfragen aus dem Themenfeld Suchmaschinenoptimierung in Deutschland. Dabei wurden insgesamt 77 Quellenangaben erfasst.
Höchstens 44 Prozent der zitierten Quellen (34 von 77) standen zugleich in den organischen Top 10 – "höchstens", weil der Abgleich auf Host-Ebene läuft. Mindestens 56 Prozent lagen außerhalb der Top 10.
Das bedeutet nicht, dass ein gutes organisches Ranking automatisch zu einer Zitierung führt. In keiner der untersuchten Suchanfragen wurden alle zehn organischen Ergebnisse zitiert. In jeder Anfrage blieb mindestens die Hälfte der organischen Treffer ungenannt.
Die Erhebung ist allerdings nur eine Momentaufnahme: 20 Suchanfragen, ein Erhebungstag und ein einzelnes Themenfeld. Sie eignet sich deshalb nicht als allgemeiner Wert für das gesamte Web.
Anteil eigener Quellen an den Antworten
Eine weitere mögliche Kennzahl ist der Anteil der untersuchten Antworten, in denen eine eigene Quelle auftaucht.
Hier muss die Bezugsgröße ausdrücklich angegeben werden. „Die Website wird in 30 Prozent der Antworten genannt" ist nur dann verständlich, wenn klar ist, wie viele Suchanfragen untersucht wurden und wie mit nicht auswertbaren Antworten umgegangen wurde.
In der genannten eigenen Erhebung ließ sich für 10 von 20 Suchanfragen überhaupt keine Zitierrate bestimmen. In neun Fällen erschien zwar eine AI Overview, aber ohne auswertbare Quellenliste. In einem Fall war die AI Overview nicht abrufbar.
Eine Zitierrate darf solche Fälle deshalb nicht einfach als „null" behandeln.
Warum ist „kein Ergebnis" nicht dasselbe wie null?
Ein fehlender Datensatz ist kein Beleg dafür, dass das gemessene Ereignis nicht stattgefunden hat.
Das hat eine eigene Erhebung bei der Auswertung von AI Overviews gezeigt. Für eine Suchanfrage wurde zunächst aus einem no result geschlossen, dass keine AI Overview erschienen sei. Am 11.09.2026 wurde diese Interpretation widerrufen.
no result bedeutete in diesem Fall lediglich: Es lag kein gespeicherter Datensatz vor.
Für dasselbe Keyword wurde am selben Tag ein AI-Answer-Feature ausgewiesen, während die konkrete Antwort weiterhin nicht abrufbar war. Ob am ursprünglichen Erhebungstag tatsächlich keine AI Overview erschienen war, ließ sich rückwirkend nicht feststellen.
Deshalb wird zwischen drei Zuständen unterschieden: vorhanden, nicht vorhanden, nicht abrufbar.
Diese Unterscheidung gehört zur Kennzahl selbst. Wer „nicht abrufbar" als null wertet, verändert die Aussage der Messung. Genau das ist auch bei der Recherche zu diesem Artikel wieder aufgetreten: Die Abfrage der SERP-Features zum Primär-Keyword dieses Beitrags lieferte am 21.09.2026 ein no result. Richtig ist deshalb „nicht abrufbar" – nicht „keine SERP-Features vorhanden".
Sind Crawler-Abrufe eine Kennzahl für KI-Sichtbarkeit?
Crawler-Abrufe können technische Hinweise liefern, belegen aber weder eine Verwendung des Inhalts noch eine Zitierung in einer KI-Antwort.
Eine eigene Crawler-Erhebung vom 31.07. bis 16.08.2026 erfasste 1.422 Zugriffe von 13 Kennungen. Davon waren 561 Zugriffe belegt, 37 wurden widerlegt und 824 blieben ohne abschließendes Urteil.
Diese drei Zustände sind wichtig. Ein Zugriff, der sich nicht einer bekannten Kennung zuordnen lässt, ist dadurch nicht automatisch ein falscher Bot. Ein Nicht-Treffer gegen einen veröffentlichten Adressbereich belegt zunächst nur, dass die Zuordnung nicht möglich war. Eine Widerlegung entsteht erst, wenn die Rückwärtsauflösung auf einen fremden Host zeigt.
Auch die Qualität der Anbieterlisten spielt eine Rolle: Microsofts Liste war über zweieinhalb Jahre alt, Perplexitys über ein halbes Jahr – ein Teil der ungeklärten Fälle liegt daran, nicht an der eigenen Prüfung.
Damit zeigt sich eine grundsätzliche Grenze dieser Kennzahl: Ein Abruf ist keine Zitierung. Wie sich die einzelnen Stufen – Abruf, Verwendung, Zitierung, Besuch – sauber auseinanderhalten lassen,ist ausführlich in „In ChatGPT gefunden werden" und „B2B-Content-Strategie für die KI-Suche" beschrieben. Für die Kennzahl heißt das: Erst wenn eine Stufe tatsächlich gemessen werden kann, darf sie als solche berichtet werden.
Warum können rohe Abrufzahlen sogar irreführend sein?
Eine hohe Zahl technischer Zugriffe ist nicht automatisch Reichweite, weil darunter auch Scanner, Bots und Zugriffe auf nicht vorhandene oder technische Pfade sein können.
Eine eigene Zugriffsmessung registrierte über 17 Tage 10.220 Treffer auf 3.888 verschiedenen Pfaden. Die betroffene Website hat allerdings nur rund 20 öffentliche Adressen.
Allein /wp-admin/install.php wurde 179-mal aufgerufen – obwohl es sich bei der Website nicht um eine WordPress-Installation handelt.
Wer daraus „3.888 Seitenaufrufe" machen würde, würde technische Scanversuche als Reichweite interpretieren.
Die Zahl wird erst aussagekräftig, wenn die abgerufenen Pfade gegen eine belastbare Grundlage geprüft werden, beispielsweise gegen die Sitemap oder die tatsächlich vorhandenen öffentlichen URLs.
Das ist ein allgemeines Prinzip für KI-Sichtbarkeitsmessungen: Ein Messwert muss gegen die Realität geprüft werden, die er angeblich beschreibt.
Welche Rolle spielen klassische SEO-Kennzahlen?
Klassische SEO-Kennzahlen bleiben relevant, beantworten aber eine andere Frage als eine Messung von KI-Zitierungen. Für Google gibt es inzwischen zusätzlich einen eigenen Bericht für generative KI-Funktionen in der Search Console.
Google stellt inzwischen einen Generative-AI-Performance-Report in der Search Console bereit. Damit lässt sich die Leistung von Inhalten in generativen KI-Funktionen von Google Search und Discover untersuchen. Google betont gleichzeitig, dass die bestehenden SEO-Grundlagen weiterhin für generative Suchfunktionen relevant sind.
Damit sind beispielsweise Impressionen und Klicks weiterhin wichtige Größen. Sie sollten aber nicht mit einer Zitierrate gleichgesetzt werden.
Ein organisches Ranking beschreibt die Sichtbarkeit in der Trefferliste. Eine Quellenangabe beschreibt eine andere Situation: Eine Quelle wird in einer generierten Antwort genannt. Wie GEO und klassisches SEO dabei zusammenhängen, ordnet :" GEO vs. SEO" ein.
Auch die Forschung zu Generative Engine Optimization misst Sichtbarkeit innerhalb generierter Antworten und nicht einfach klassische Suchmaschinenpositionen. Das GEO-Paper von Aggarwal et al. untersucht dafür eigene Sichtbarkeitsmetriken und berichtet je nach Versuchsaufbau Verbesserungen der Sichtbarkeit in generativen Antworten. Die Ergebnisse stammen aus einem kontrollierten Forschungsaufbau und sind nicht als allgemeine Rankingprognose zu verstehen.
Die beiden Perspektiven lassen sich deshalb ergänzen, sollten aber nicht zu einer einzigen Kennzahl vermischt werden.
Wie lässt sich eine Kennzahl über längere Zeit vergleichen?
Vergleichbare Messungen brauchen ein konstantes Abfrageset, eine dokumentierte Ausgangslage und dieselbe Auswertungslogik.
Dafür sollten mindestens drei Dinge dokumentiert werden: der genaue Wortlaut der Suchanfragen oder Prompts, die Ausgangslage und der Erhebungszeitpunkt, die verwendete Erhebungs- und Auswertungsmethode.
Auch die Bezugsgröße muss gleich bleiben.
Wenn heute 20 Suchanfragen untersucht werden und beim nächsten Mal 50 andere, kann eine Veränderung der Quote allein durch das neue Abfrageset entstehen.
Ebenso wichtig ist die Behandlung nicht auswertbarer Antworten. Wenn „nicht abrufbar" heute aus der Berechnung herausfällt und beim nächsten Mal als null gewertet wird, sind die beiden Ergebnisse nicht miteinander vergleichbar.
Die Rechenlogik gehört deshalb zur Kennzahl.
Welche Datenquellen können dafür verwendet werden?
Je nach Messfrage kommen Search Console, Server-Protokolle, Antwortdaten und spezialisierte Werkzeuge infrage – aber jede Quelle hat eine andere Aussagegrenze.
Die Search Console ist für Google-Suchdaten eine zentrale Quelle. Der neue Generative-AI-Performance-Report ergänzt diese Daten um die Leistung in Googles generativen Suchfunktionen.
Server-Protokolle können technische Zugriffe und bestimmte User Agents sichtbar machen. Ihre Aussagekraft hängt allerdings davon ab, ob die Zugriffe zuverlässig identifiziert und von normalem Traffic oder Scan-Rauschen getrennt werden können.
Spezialisierte Werkzeuge können KI-Antworten und deren Quellen automatisiert erfassen. Google weist allerdings darauf hin, dass Drittanbieter keinen Zugriff auf Googles interne Ranking- oder KI-Systeme haben. Solche Werkzeuge können einen Messprozess unterstützen, sollten aber nicht mit einer direkten Einsicht in Googles interne Systeme gleichgesetzt werden.
Keine dieser Quellen beantwortet allein sämtliche Fragen.
Ein Search-Console-Klick ist ein Klick aus der Google-Suche. Ein Server-Abruf ist ein technischer Zugriff. Eine Quellenangabe in einer KI-Antwort ist eine Zitierung.
Wer diese Werte einfach zusammenzählt, erhält keine umfassendere Kennzahl, sondern vermischt unterschiedliche Vorgänge.
Was sollte in einem brauchbaren Bericht stehen?
Ein brauchbarer Bericht nennt nicht nur Werte, sondern auch deren Bezugsgröße, Datenbasis und Grenzen.
Dazu gehören je nach Ziel beispielsweise: die Anzahl der untersuchten Suchanfragen, der Anteil der auswertbaren Antworten, Erwähnungen, Zitierungen, die eigenen Quellen innerhalb der Antworten, die Position beziehungsweise Einordnung einer Quelle in der Antwort, Überschneidungen mit den organischen Suchergebnissen, identifizierbare Besuche aus KI-Systemen, nicht auswertbare Fälle.
Jede Kennzahl braucht dabei ihre Bezugsgröße.
„30 Prozent KI-Sichtbarkeit" ist keine vollständige Aussage.
„Bei 6 von 20 definierten Suchanfragen wurde die eigene Website als Quelle genannt; 4 weitere Antworten waren wegen fehlender Quellenangaben nicht auswertbar" ist wesentlich nachvollziehbarer.
Die zweite Formulierung macht sichtbar, was gezählt wurde – und was nicht.
Was sollte ein Bericht ausdrücklich nicht behaupten?
Aus einer Kennzahl sollte nur das abgeleitet werden, was diese Kennzahl tatsächlich misst.
Ein Crawler-Abruf beweist keine Zitierung. Eine Zitierung beweist keinen Klick. Ein Klick beweist keinen Lead. Und ein organisches Ranking garantiert keine Aufnahme in eine KI-Antwort.
Auch technische Maßnahmen sollten nicht automatisch als messbarer Sichtbarkeitshebel dargestellt werden. Google erklärt ausdrücklich, dass keine besondere schema.org-Auszeichnung nötig ist, um in den generativen KI-Funktionen von Google Search zu erscheinen. Strukturierte Daten können weiterhin Teil einer SEO-Strategie sein, sind aber kein spezieller KI-Sichtbarkeitshebel – wie : "Strukturierte Daten für KI-Sichtbarkeit" im Detail zeigt.
Für llms.txt gilt ein ähnliches Bild, nur mit einer eigenen Zahl dazu: Eine Auswertung von Ahrefs (Stichmonat Mai 2026, 137.210 Domains) fand, dass 97 Prozent aller eingerichteten llms.txt-Dateien in diesem Zeitraum kein einziges Mal abgerufen wurden. Anlegen kann man die Datei trotzdem – nur eben nicht als belegten Sichtbarkeitshebel. Wie das geht, steht in der Anleitung zu :" llms.txt".
Was ist dann eine gute Kennzahl für KI-Sichtbarkeit?
Eine gute Kennzahl ist vor allem eine nachvollziehbare Kennzahl: Sie definiert, was gezählt wird, unter welchen Bedingungen gemessen wurde und welche Schlussfolgerung daraus zulässig ist.
Bei KI-Sichtbarkeit stehen mehrere unterschiedliche Vorgänge nebeneinander: Eine Seite kann gecrawlt, inhaltlich verwendet, als Quelle zitiert und anschließend von einem Nutzer besucht werden. Diese Ereignisse gehören zusammen, sind aber nicht dasselbe.
Meine Position ist deshalb: Für das Reporting ist eine kleinere Zahl mit klarer Datenbasis wertvoller als ein umfassender Sichtbarkeitsindex, dessen Berechnung fehlende Antworten, nicht identifizierbare Abrufe oder wechselnde Abfragen versteckt. Die Crawler- und Zugriffsdaten stammen dabei von einer einzelnen, noch jungen Domain – die Größenordnungen sind deshalb nicht ungeprüft auf andere Websites übertragbar.
„Eine Kennzahl ist nur dann belastbar, wenn klar ist, was gezählt wurde und unter welchen Bedingungen. Ein fehlender Messwert darf nicht stillschweigend zu einem negativen Ergebnis werden."
— Andreas Junius
Wer diese Unterscheidungen berücksichtigt, kann Veränderungen nachvollziehbar dokumentieren, ohne aus technischen Zugriffen, Rankings und Zitierungen eine scheinbar präzise Gesamtzahl zu machen.
Wenn Sie Ihre Sichtbarkeit in KI-gestützten Suchsystemen systematisch untersuchen möchten, erfahren Sie mehr über unsere GEO-Optimierung.
Stand: 22.09.2026
Alle Beträge netto zzgl. gesetzlicher Umsatzsteuer; Angebote ausschließlich an Unternehmer im Sinne des § 14 BGB.
Häufige Fragen
1. Reicht eine einzelne Kennzahl, um KI-Sichtbarkeit zu belegen?
Nein. Erwähnung, Zitierung, Abruf und Besuch sind unterschiedliche Vorgänge – eine Zahl allein blendet immer einen Teil davon aus.
2. Sagt ein gutes Google-Ranking etwas über die KI-Zitierrate aus?
Nicht zuverlässig. In der eigenen Erhebung lag höchstens rund ein Drittel der Top-10-Treffer auch als KI-Zitat vor – der Rest nicht.
3. Wie geht man mit Suchanfragen um, zu denen keine KI-Antwort abrufbar ist?
Nicht als „null" werten. Es gilt die dritte Kategorie „nicht abrufbar", getrennt von vorhanden und nicht vorhanden, sonst verfälscht das die Zahl.
4. Braucht man strukturierte Daten oder llms.txt, um in KI-Antworten zu erscheinen?
Für strukturierte Daten laut Google nicht. Bei llms.txt zeigt eine Ahrefs-Auswertung: 97 Prozent der Dateien wurden nie abgerufen.
5. Was macht eine KI-Sichtbarkeits-Kennzahl über Monate hinweg vergleichbar?
Ein festes Abfrageset, eine dokumentierte Ausgangslage und eine gleichbleibende Auswertungslogik – sonst sind zwei Messungen nicht vergleichbar.
Ähnliche Artikel
In ChatGPT gefunden werden: Leitfaden für B2B-Unternehmen
In ChatGPT führt kein Anmeldeweg — aber ein dokumentierter Abrufweg. Dieser Beitrag trennt die zwei Wege in eine ChatGPT-Antwort, benennt die drei Crawler-Kennungen von OpenAI samt ihrer Zwecke und stellt eine eigene Messung daneben: 870 Zugriffe mit OpenAI-Kennung auf peilwerk.de vom 31. Juli bis 30. August 2026, 374 davon belegt. Daraus folgen sechs Ansatzpunkte, eine Reihenfolge für den Anfang und ein Einwand gegen jeden, der Sichtbarkeit im Server-Protokoll sucht. Stand: 12. September 2026.
AI Overviews: Die Zukunft der Google-Suche verstehen und für Ihr Unternehmen nutzen
Google zeigt immer häufiger eine KI-Zusammenfassung noch vor den klassischen Suchergebnissen. Was das für Ihre Sichtbarkeit bedeutet – und wie Sie zur zitierten Quelle werden.
Answer Engine Optimization (AEO): Was es ist und wie es funktioniert
Answer Engine Optimization ist gerade erst als Begriff aufgetaucht. Ist das ein eigenes Fachgebiet — oder nur ein neues Wort für Bekanntes? Wir ordnen ein, was wirklich dahintersteckt.